Giảm chatbot AI bịa thông tin: kiểm soát bằng kiến trúc
Trợ lý của chúng tôi từng bịa ra sáu nhân viên với những cái tên không có thật, trong khi đội chỉ có bốn người. Cách sửa không phải là dặn nó kỹ hơn.
 Zukatek Journal8 phút đọc
Lần đầu bật trợ lý AI cho website, chúng tôi hỏi nó một câu đơn giản: "Đội ngũ gồm những ai?"
Nó trả lời rành mạch, liệt kê sáu người với tên, chức danh và mô tả công việc. Đọc rất thuyết phục.
Đội có bốn người. Không ai trong sáu cái tên đó có thật.
Vì sao viết thêm lời dặn không giải quyết được
Phản xạ đầu tiên của ai cũng giống nhau: thêm một dòng vào lời nhắc hệ thống. "Tuyệt đối không được bịa tên người."
Nó có tác dụng. Một phần. Trong phần lớn trường hợp. Và đó chính là vấn đề.
Một lời dặn trong prompt là một đề nghị gửi cho một hệ thống xác suất. Nó làm giảm khả năng xảy ra, không triệt tiêu. Mỗi lần người dùng hỏi theo một cách hơi khác, bạn lại đánh cược một lần nữa — và bạn không biết tỷ lệ thua là bao nhiêu.
Chỗ này có một ranh giới rất đáng nhớ:
Những gì mô hình không có trong ngữ cảnh thì nó không thể trích chính xác. Nhưng những gì nó không có, nó hoàn toàn có thể bịa.
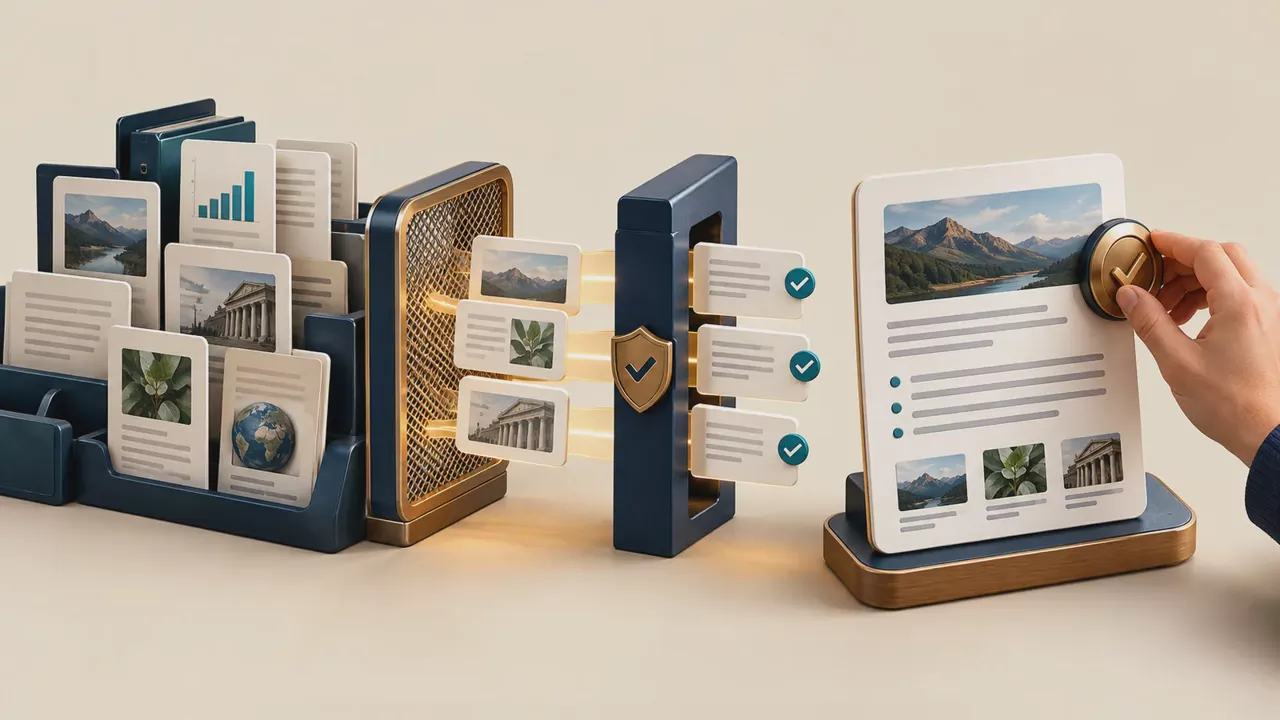
Nên câu hỏi đúng không phải "làm sao dặn cho nó nghe lời", mà "làm sao để câu trả lời sai trở thành bất khả thi về mặt cấu trúc".
Ba mức kiểm soát, từ yếu tới mạnh
Mức 1 — Lời dặn (yếu nhất)
Không được bịa tên người, số lượng thành viên hay vai trò.Đây là thứ chúng tôi vẫn giữ, nhưng chỉ như lớp cuối cùng. Trong mã nguồn, ngay cạnh dòng này, chúng tôi ghi một chú thích thẳng thắn: đây là chỗ duy nhất mà văn bản đang làm việc thật thay vì mô tả việc đã được kiến trúc bảo đảm — và cần biết rằng nó yếu hơn.
Ghi rõ chỗ yếu là một phần của việc làm cho nó an toàn. Thứ nguy hiểm là một lớp bảo vệ mà ai cũng tưởng chắc chắn.
Mức 2 — Giảm dữ liệu nhạy cảm trong ngữ cảnh
Quy tắc giá: "Không nói về giá, gói cước, chiết khấu."
Không đưa bảng giá nội bộ vào ngữ cảnh giúp giảm nguy cơ lộ dữ liệu đó. Nhưng mô hình vẫn có thể tự tạo một mức giá nghe hợp lý. Giảm dữ liệu nhạy cảm không đồng nghĩa ngăn bịa. Nếu sản phẩm không được phép báo giá, ứng dụng cần chặn ý định báo giá hoặc trả một mẫu cố định đã duyệt. Vẫn phải kiểm tra đầu ra, quyền truy cập công cụ và dữ liệu được truy xuất.
Mức 3 — Tra cứu có kiểm tra ở phía ứng dụng
Với dữ liệu mà trợ lý cần trả lời — danh sách sản phẩm, danh sách nhân sự — không thể không đưa vào. Giải pháp là không đưa sẵn, mà bắt nó đi hỏi:
Mọi thông tin về sản phẩm, đội ngũ, con người phải lấy từ kết quả công cụ.
Không có trong công cụ thì nói là chưa có thông tin.
Dùng list_members; công cụ trả về bao nhiêu người thì đúng bấy nhiêu.
Công cụ cung cấp đường tra cứu dữ liệu đã được duyệt; bản thân dữ liệu cũng cần được cập nhật và kiểm tra quyền truy cập.
Tuy nhiên, chỉ khai báo công cụ vẫn chưa bảo đảm mô hình sẽ dùng nó. Công cụ là nguồn duy nhất, nhưng không có gì ngăn mô hình trả lời từ trí nhớ của nó thay vì gọi công cụ. Đó đúng là chuyện đã xảy ra với sáu cái tên bịa.
Biện pháp mạnh hơn là ứng dụng bắt buộc tra cứu cho loại câu hỏi này, kiểm tra ID và số lượng trong câu trả lời, rồi từ chối hoặc chuyển người thật khi thiếu bằng chứng. Với danh sách nhân sự, có thể hiển thị trực tiếp bằng mẫu từ dữ liệu đã duyệt, không cho mô hình tự viết lại tên. Ba lớp này giải quyết các rủi ro khác nhau, không phải một thang bảo đảm tuyệt đối.
Những quyết định nhỏ hơn nhưng quan trọng
Khung chat hẹp thì đừng cho vẽ bảng
Trợ lý của chúng tôi bị cấm dùng bảng Markdown. Không phải vì bảng xấu, mà vì khung chat rộng khoảng 360 điểm ảnh — bảng nhiều cột thường khó đọc nếu không có bố cục thích ứng. Thay vì dạy giao diện vẽ bảng cho khéo, chúng tôi bảo trợ lý đừng dùng bảng.
Khi một thứ không thể hiển thị tốt, cách rẻ nhất là đừng tạo ra nó.
Định dạng phải hiển thị, nhưng đừng bao giờ thành HTML
Mô hình trả về đậm kiểu Markdown. Nếu để nguyên, người dùng thấy dấu sao. Một số cách render Markdown sinh chuỗi HTML và chèn bằng dangerouslySetInnerHTML; những thư viện khác render thành phần tử giao diện. Không phải mọi thư viện Markdown đều cần chèn HTML thô.
Và đây là chỗ nguy hiểm: đầu ra của mô hình bị khách lạ nắn được. Bảo trợ lý nhắc lại một đoạn, nó nhắc lại. Nếu đoạn đó là mã độc và bạn biến nó thành HTML, bạn vừa tạo ra một lỗ hổng tấn công lưu trữ.
Chúng tôi tự viết một thành phần nhỏ, chỉ hiểu đậm, nghiêng, ` mã ` và dòng tiêu đề, và trả về phần tử giao diện chứ không trả về chuỗi. Không có điểm nào trong toàn bộ đường đi mà một chuỗi bị diễn giải thành HTML — cách này loại bỏ đường chèn HTML thô trong thành phần đó. Vẫn phải kiểm tra giao thức URL, liên kết và các thành phần mở rộng; không thể suy ra toàn bộ ứng dụng miễn nhiễm XSS.
Ngôn ngữ trả lời phải theo người đọc
Site có hai ngôn ngữ. Ban đầu lời nhắc cứng tiếng Việt, nên khách đọc bản tiếng Anh vẫn nhận câu trả lời tiếng Việt.
Cách sửa đáng nói ở chỗ chúng tôi không dịch toàn bộ lời nhắc. Giữ bộ quy tắc bằng một ngôn ngữ (nếu nhân đôi, hai bản sẽ lệch nhau và những quy tắc quan trọng nhất là thứ lệch đầu tiên), chỉ thêm một khối ngôn ngữ đặt lên trên:
RESPONSE LANGUAGE — security and access rules still apply
- The brief that follows is written in Vietnamese. Do not copy its language;
  follow its rules and answer in English.
- Exception: if the visitor asks for another language, use that one.
Và ngoại lệ cuối cùng là cố ý: khách viết "trả lời bằng tiếng Anh" trong trang tiếng Việt thì đang yêu cầu tiếng Anh. Từ chối điều đó là máy móc.
Danh sách kiểm tra trước khi bật chatbot
Liệt kê mọi thứ trợ lý không được nói — giá, cam kết tiến độ, tư vấn pháp lý
Với mỗi thứ, hỏi: dữ liệu đó có nằm trong ngữ cảnh không? Nếu có, bỏ ra
Với dữ liệu buộc phải có, đưa qua công cụ tra cứu, đừng đưa sẵn
Bắt buộc tra cứu khi cần; kiểm tra ID, số lượng và quyền ở phía ứng dụng
Render an toàn, không chèn HTML thô chưa xử lý; kiểm tra cả URL liên kết
Thử hỏi đúng những câu bạn sợ nhất, bằng vài cách diễn đạt khác nhau
Bước 6 là bước hay bị bỏ. Chúng tôi chỉ phát hiện ra sáu cái tên bịa vì có người hỏi một câu rất bình thường.
Tình huống sáu nhân viên được thuật lại từ bản thảo Zukatek tháng 10/2026; nhật ký gốc chưa có trong thư mục để kiểm chứng độc lập.
Nguồn đối chiếu: OWASP — LLM Misinformation.
Có thể bạn quan tâm
Bảy cái bẫy khi sao lưu và chuyển dữ liệu — chúng tôi vấp đủ cả bảy
Một bản sao lưu nạp được ở máy mình không có nghĩa là nạp được ở máy chủ. Bảy chỗ hỏng thật, theo đúng thứ tự chúng tôi gặp.
Đọc bài viết
Tối ưu server: đo trước, sửa sau — và những con số thật từ một VPS 3GB
Chúng tôi đo toàn bộ đường đi của một yêu cầu, từ trình duyệt tới cơ sở dữ liệu. Máy chủ trả lời trong 3 mili giây, người dùng chờ 130. Bài này chỉ ra cách tách thời gian xử lý, đường truyền và tải tài nguyên.
Đọc bài viết
Ba bài toán mà nhóm nhỏ nào cũng gặp — và cách giải không cần phần mềm đắt tiền
Không phải vấn đề công cụ. Ba thứ này giết năng suất của nhóm 3–20 người, và cả ba đều giải được bằng thay đổi cách làm trước khi cần mua gì.
Đọc bài viết